Så fungerar query fan-out i AI-sök – vad datan visar
SEO-konsult & Google Ads-specialist
En fråga till ChatGPT eller Googles AI Mode resulterar sällan i en sökning på exakt det som skrevs. Istället skrivs frågan om, delas upp och skickas iväg som en eller flera sökningar som inte visas för användaren. Det är dessa sökningar och inte prompten som avgör vilka sidor som hämtas – och därmed avgör vilka som kan citeras i svaret.
Tekniken kallas query fan-out, och att bena ut hur det fungerar är förstås viktigt för alla med minsta SEO-intresse. Här tittar vi närmare på vad några av de större studierna hittills visar och vad de kan betyda rent praktiskt.
Timingen är bra. I veckan publicerade Ahrefs en analys av 15 miljoner fan-out-frågor från ChatGPT som delvis ger en annan bild än tidigare studier. Skillnaderna är intressanta i sig.
Kort version:
- AI-sök skriver om användarfrågan till en eller flera delfrågor innan de körs som vanliga sökningar.
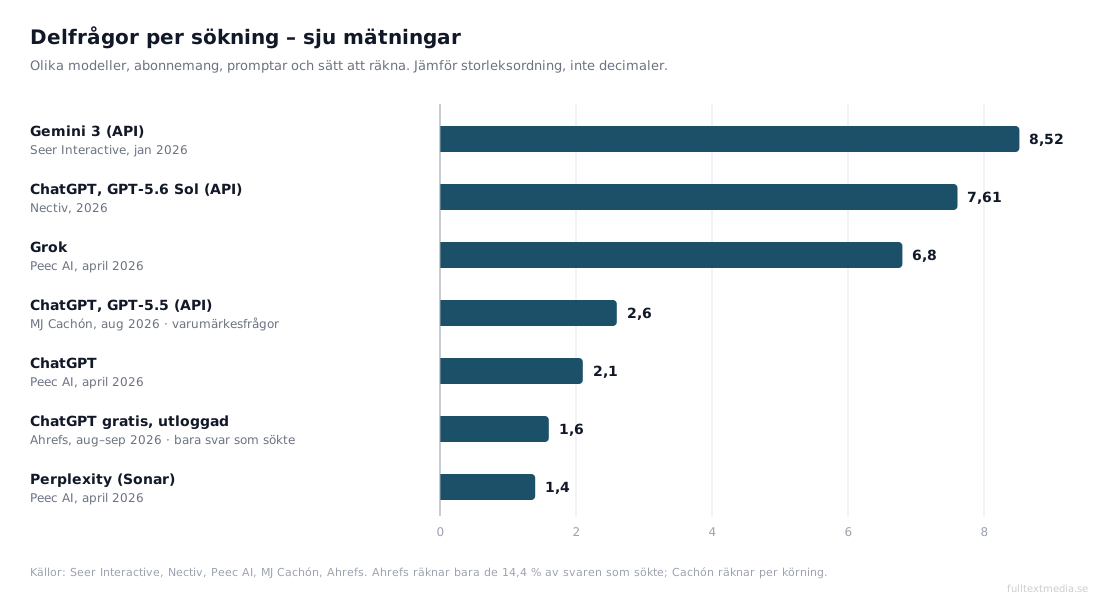
- Antalet varierar kraftigt: från ett snitt på 1,6 delfrågor per sökning i gratisversionen av ChatGPT till över 8 i Gemini 3 via API.
- Delfrågorna är inte givna på förhand. Bara omkring var fjärde återkommer när samma prompt upprepas.
- Sidor som rankar för flera delfrågor citeras oftare än sidor som bara rankar för huvudfrågan.
- För icke-engelska promptar körs 43 % av ChatGPT:s delfrågor på engelska, enligt Peec AI.
Vad är query fan-out?
Begreppet kommer från Google och beskrivs i dokumentationen AI features and your website som ett sätt att göra ”multiple related searches across subtopics and data sources” för att få fram ett svar.
Frågan bryts ner i delämnen och systemet skickar en mängd sökningar samtidigt för användarens räkning. Deep Search tar samma teknik längre och kan köra hundratals sökningar för en och samma fråga. Robby Stein, produktansvarig för Google Search, har förklarat att LLM:en även söker på saker användaren inte nämnt. Om du planerar en gruppresa till Finspång kan AI Mode på eget initiativ söka efter bra restauranger.
Principen är inte exklusiv för Google utan gäller alla AI-tjänster med integrerad webbsökning, inklusive ChatGPT, Perplexity, Claude, Grok och Gemini. OpenAI har inte dokumenterat hur ChatGPT väljer sina sökningar, så det vi vet kommer från studier av vad modellerna faktiskt söker på.
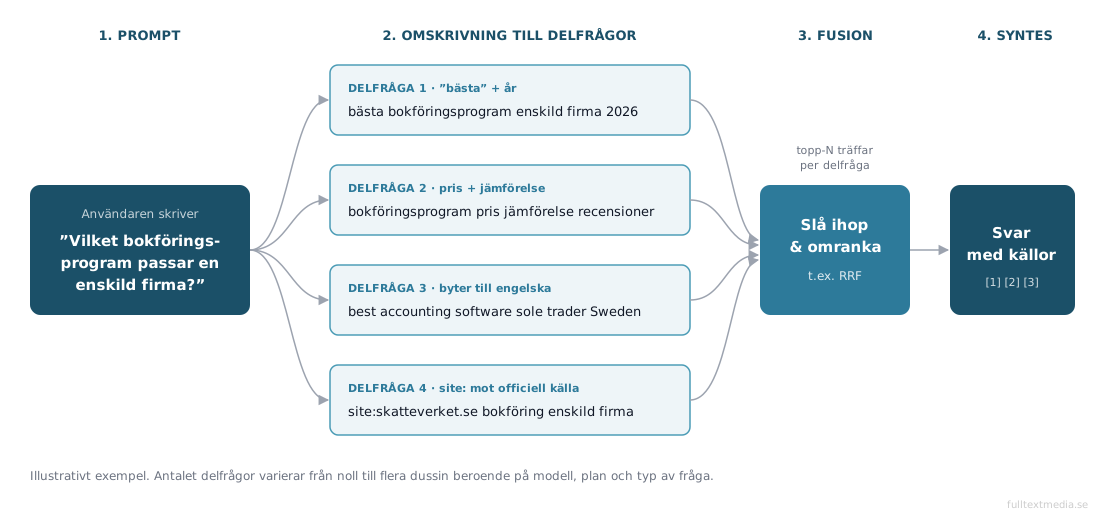
Förenklat går det till så här:
- Beslut om sökning. Modellen avgör först om den behöver söka alls eller klarar sig på träningsdata. Enligt Ahrefs utlöste bara 14,4 % av 66,6 miljoner svar i gratisversionen av ChatGPT en webbsökning. Det är en kostnads- och resursfråga.
- Omskrivning. Frågan formuleras om till en eller flera delfrågor, inte sällan med ord som användaren aldrig skrev: årtal, ”bästa”, ”officiell”,
site:-operatorer med mera. - Hämtning. Varje delfråga körs mot ett sökindex och modellen får tillbaka en träfflista per delfråga.
- Fusion och omrankning. Listorna slås ihop till en. Metehan Yesilyurt hittade 2025 spår av Reciprocal Rank Fusion i ChatGPT:s webbgränssnitt (mer om detta nedan).
- Syntes. Modellen väljer ut passager ur de hämtade sidorna och sammanställer ett svar med källhänvisningar.
Två exempel
Tabellen nedan visar hur fan-out skulle kunna se ut för två svenska frågor. Exemplen bygger på mönstren i studierna längre ner.
| Prompt | Möjlig delfråga | Vad modellen lagt till |
|---|---|---|
| Vilket bokföringsprogram passar en enskild firma? | bästa bokföringsprogram enskild firma 2026 | ”bästa” + årtal |
| bokföringsprogram pris jämförelse recensioner | pris, jämförelse, recensioner | |
| best accounting software sole trader Sweden | byte till engelska | |
| site:[leverantör].se priser enskild firma | site: mot leverantörens sajt | |
| Behöver jag bygglov för en altan? | bygglov altan regler 2026 | årtal |
| site:boverket.se altan bygglovsbefriad | site: mot myndighet | |
| ”altan” “bygglov” [kommun] | exakta fraser, lokal precisering |
Notera att ingen av delfrågorna är identisk med prompten, vilket är en viktig poäng: du kan ranka etta på det användaren skrev och ändå inte finnas med bland det LLM:en hämtar.
Vad studierna visar
Under 2026 har ett halvdussin större analyser publicerats. De mäter i många fall olika saker på olika sätt, så det lönar sig att ställa upp dem bredvid varandra innan man drar slutsatser.
| Studie | Modell och uppsättning | Underlag | Delfrågor per sökning | Notering |
|---|---|---|---|---|
| Ahrefs (okt 2026) | ChatGPT, GPT-5.6 Luna, gratis och utloggad | 66,6 M svar, 15 M delfrågor, aug–sep 2026 | ~1,6 | Bara 14,4 % av svaren sökte. site: i 6,8 % |
| Peec AI (maj 2026) | ChatGPT, Perplexity, Grok | 5 M delfrågor, april 2026 | 2,1 / 1,4 / 6,8 | ”best” i 24,3 % av delfrågorna för rådsfrågor |
| MJ Cachón (aug 2026) | GPT-5.5 via API, varumärkesfrågor | 189 promptar, 723 körningar, 1 797 delfrågor | 2,6 per körning | 10,3 unika delfrågor per prompt över flera körningar |
| Nectiv (2026) | GPT-5.6 Sol via API | ~4 000 promptar | 7,61 | Upp från 2,17 året innan. site: i 64 % |
| Seer Interactive (jan 2026) | Gemini 3 via API | 1 300 promptkörningar, 11 029 unika delfrågor | 8,52 | Bara 8 delfrågor återkom i alla 13 körningar |
| Surfer (uppd. sep 2026) | Gemini-genererade delfrågor mot Googles SERP | 10 000 sökord, 33 000 delfrågor, 173 902 URL:er | – | Korrelation 0,77 mellan fan-out-rankning och AIO-citering |
Varför skiljer sig siffrorna så mycket?
Spannet mellan 1,4 och 8,52 delfrågor beror inte på felräkning. Det finns fyra förklaringar:
- Abonnemang och modell. Ahrefs mätte gratisversionen utan inloggning, eftersom över 90 % av ChatGPT:s användare inte betalar. Gratisvarianten söker av ekonomiska skäl mindre och lutar sig mer mot träningsdata. API-anrop och resonerande modeller gör betydligt fler sökningar. Suganthan Mohanadasan såg 15–40 delfrågor per konversation med ChatGPT Thinking, i ett litet urval på 57 konversationer (redovisat hos Ahrefs).
- Typ av prompt. Kommersiella ”bästa X”-frågor triggar fler sökningar än faktafrågor. Hos Nectiv låg mjukvara högst med 10,7 delfrågor per prompt, samtidigt som resor och kreditkort låg under 6.
- Vad som räknas. Ahrefs räknar bara svar där modellen faktiskt sökte. Cachón räknar per körning, men visar samtidigt att varje prompt gav 10,3 unika delfrågor när den kördes flera gånger.
- Tid. Modellerna utvecklas i snabb takt och byts ut lika fort. Nectiv såg antalet delfrågor mer än tredubblas på ett år, från 2,17 till 7,61.
Slutsatsen för den som jobbar med SEO är att ingen enskild siffra eller studie är hela sanningen om fan-out. Vad som har betydelse är hur just din målgrupp använder AI-sök (och för vilka typer av frågor).
Vad modellen lägger till
Fan-out handlar inte bara om att dela upp frågan. LLM:en lägger till ord. Vilka orden är säger mycket om vilka sidor den letar efter. Ahrefs jämförde de vanligaste orden i ChatGPT:s delfrågor mellan augusti och september 2026:
| Ord i delfrågan | Augusti | September | Förändring |
|---|---|---|---|
| 2026 | 17,6 % | 22,9 % | +5,2 procentenheter |
| official | 10,1 % | 13,1 % | +3,0 |
| price | 6,0 % | 8,9 % | +2,8 (+47 % relativt) |
| best | 5,0 % | 5,3 % | +0,3 |
| site | 4,0 % | 4,8 % | +0,8 |
| reviews | 2,7 % | 3,6 % | +0,9 |
| meaning | 2,9 % | 2,3 % | −0,6 |
Mönstret är att modellen i ökande grad söker efter färsk information, officiella källor, priser och omdömen. Definitionsord som “betyder” och “definition” minskar.
Peec AI visar samma sak från ett annat håll. ChatGPT gör om råd-frågor till ”bästa”-sökningar oavsett kategori. ”Which Samsung Galaxy should I get?” blir ”best Samsung Galaxy phones comparison 2026”. För råd-frågor innehåller 24,3 % av delfrågorna ordet ”best”. Det förklarar till stor del varför listicles dominerar bland de citerade källorna.
Nectiv noterade också att ChatGPT numera ofta söker på både innevarande och föregående år, just nu alltså ”2026” och ”2025”, för att fånga innehåll från båda.
site: – modellen går direkt till källan
Andelen delfrågor med site: varierar mer än något annat mått:
| Studie | Andel delfrågor med site: | Typ av promptar |
|---|---|---|
| Ahrefs | 6,8 % | Bred sökefterfrågan, gratisversionen |
| MJ Cachón | 30,2 % | Varumärkesfrågor |
| Nectiv | 64 % | Kommersiella frågor, API |
| Wil Reynolds (via Ahrefs) | 76 % | Litet urval av spårade promptar |
Vid breda frågor använder modellen sällan site:. När den har snävat in sig på några leverantörer går den rakt till deras sajter. Bland de ca 160 domäner som oftast söktes med site: hos Ahrefs var 75,9 % av sökningarna riktade mot varumärkens egna sajter, där Apple, IKEA och Nike toppar listan.
Hos Cachón riktades 55,1 % av site:-sökningarna mot varumärkets egen domän och 0,1 % mot en konkurrent. Modellen kontrollerar fakta hos avsändaren.
Samma tendens kan ses i vilka källor som citeras. Ahrefs testade 20 000 amerikanska promptar och såg att 84,4 % av svaren på faktafrågor (pris, funktioner, företagsuppgifter) citerade minst en officiell källa. Andelen för jämförelsefrågor var 68,3 %.
Kedjan eskalerar
Cachóns studie visar även i vilken ordning modellen söker. Första sökningen är oftast naturligt språk. Om modellen inte kommer fram till någon slutsats blir sökningarna som följer allt mer preciserade – site: är fyra gånger vanligare i sista sökningen än i första, och citattecken 25 gånger vanligare.
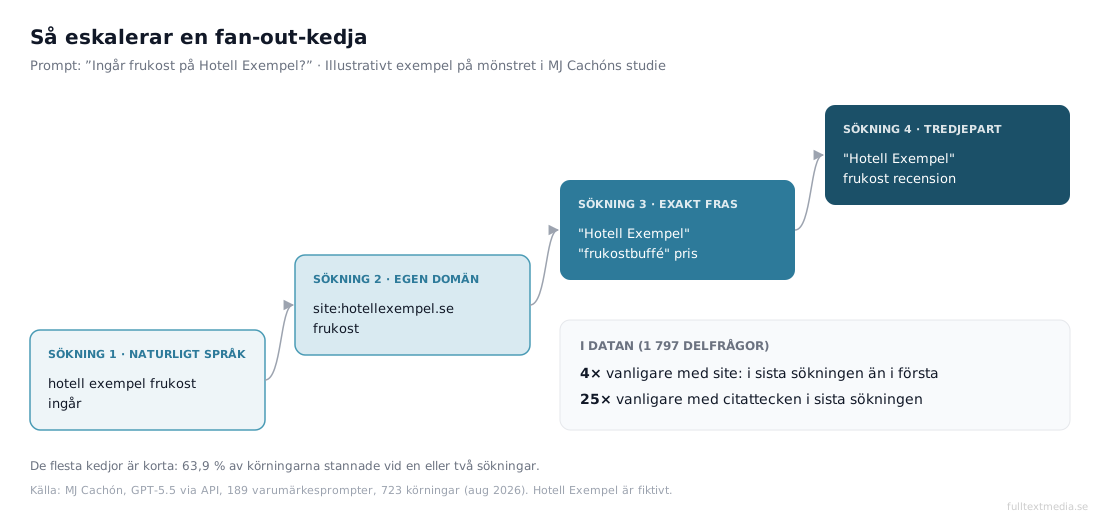
De flesta kedjor är korta och 63,9 % av körningarna stannade efter en eller två sökningar. Men när modellen inte hittar svaret hos varumärket fortsätter den och hamnar då ofta hos tredje part.
I ett av projekten från samma studie körde modellen site: mot en gammal domän som sedan länge redirectade till den nya. Det är ännu ett skäl att aldrig ta bort dina redirects efter en domänflytt eller migrering.
Delfrågorna är instabila
Om fan-out-frågor vore stabila skulle man kunna behandla dem som sökord, d.v.s. ta fram en lista, optimera och följa upp. Så enkelt är det tyvärr inte.
- Surfer såg att bara ca 27 % av delfrågorna återkom när samma prompt kördes flera gånger.
- Seer Interactive körde samma 100 promptar i Gemini 3 två gånger om dagen i en vecka, totalt 13 körningar. Av 11 029 unika delfrågor var det bara 8 stycken som dök upp i alla körningar.
- MJ Cachón fann att en enskild körning bara visade ungefär en fjärdedel av de unika delfrågor som fyra körningar gav tillsammans.
Seer gjorde ytterligare en intressant iakttagelse: 99 % av delfrågorna hade noll i månatlig sökvolym. Med andra ord syns de kanske inte alls i Ahrefs, Semrush eller Googles sökordsplanerare. En klassisk sökordsanalys fångar inte vad AI-tjänsterna faktiskt söker på.
Slutsatsen är att jobba mer med teman än exakta frågor. Seer analyserade återkommande ordpar (bigram) i stället för hela delfrågor. De vanligaste var ”2024 2025”, vilket pekar mot färskhet, och ”case studies”, vilket pekar mot bevis och trovärdighet. Teman som återkommer i en stor majoritet av körningarna är värda att prioritera, medan enstaka delfrågor kan behandlas som rent brus.
Från hämtning till citering
Att en sida hämtas är inte samma sak som att den citeras i svaret. Vad är det då som avgör vilka av de hämtade sidorna som visas med länk?
Ranka för flera delfrågor
Surfers studie visar den mest direkta kopplingen mellan fan-out och citeringar. Man skrapade topp 10 för 10 000 sökord, varav 76 % visade AI Overviews. Med Gemini genererades 33 000 fan-out-frågor, vars topp 10 också skrapades.
Resultatet: Spearman-korrelationen mellan hur många fan-out-frågor en sida rankar för och hur ofta den citeras var 0,77. Sidor som rankade för både huvudfrågan och fan-out-frågor var 161 % mer sannolika att bli citerade jämfört med sidor som bara rankade för huvudfrågan.
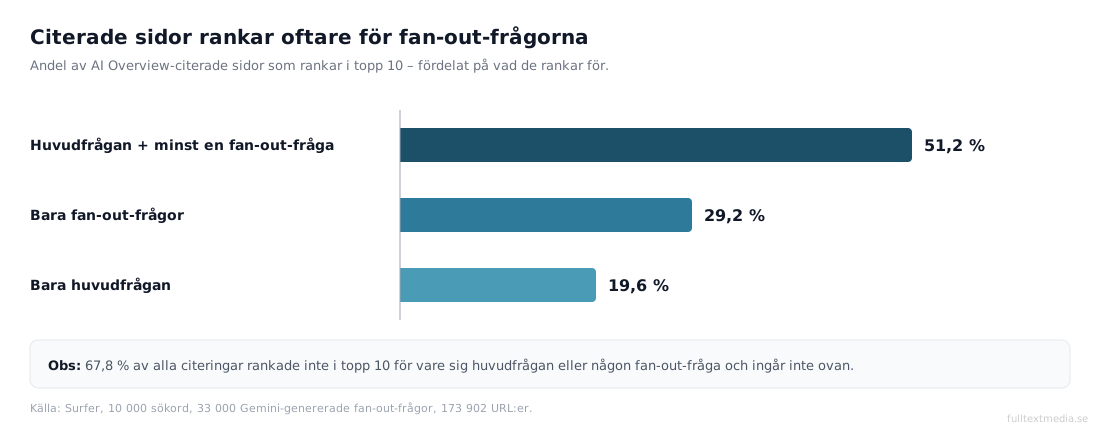
Det mest intressanta i diagrammet är att sidor som bara rankar för fan-out-frågor citeras oftare (29,2 %) än sidor som bara rankar för huvudfrågan (19,6 %). Sökningar du följer i din rankingrapport är alltså inte nödvändigtvis avgörande.
Två förbehåll: korrelation är inte kausalitet. Och 67,8 % av alla citeringar i studien rankade inte i topp 10 för någon av frågorna. AI Overviews hämtar uppenbarligen från betydligt fler källor än de tio blå länkarna.
Det stämmer också med andra mätningar. SE Ranking jämförde 9 721 sökord och såg att bara 14 % av URL:erna i AI Mode också fanns i organiska topp 10 för samma fråga (21,9 % på domännivå). Fan-out är en stor del av förklaringen – svaret bygger på sökningar som inte dyker upp i din rank tracker.
Reciprocal Rank Fusion
När flera träfflistor ska bli en behövs en metod för att slå ihop dem. Metehan Yesilyurt hittade förra året kod i ChatGPT:s webbgränssnitt som pekar på Reciprocal Rank Fusion (RRF), en etablerad metod från informationssökning. Principen är enkel:
Poäng = summan av 1 / (k + placering) för varje lista där sidan förekommer, där k ofta är 60.
Med k = 60 blir effekten påtaglig:
| Sida | Placeringar | RRF-poäng |
|---|---|---|
| A | Etta för en delfråga, saknas i övriga | 1/61 = 0,0164 |
| B | Tvåa för två delfrågor | 2 × 1/62 = 0,0323 |
| C | Plats 6, 8 och 10 för tre delfrågor | 1/66 + 1/68 + 1/70 = 0,0442 |
En sida som är ”helt okej” för tre delfrågor slår sidan som är klockren för en. Dock är Yesilyurt tydlig med att exakt formel och värde på k är hans egna hypoteser och att implementationen kan ändras. Se RRF som en modell för hur det sannolikt fungerar och inte en bekräftad algoritm.
Mike King på iPullRank har formulerat konsekvensen väl: svaret i AI Mode är ett resultat av syntes, inte av vad som rankar för en enskild fråga.
Svenska frågor, engelska sökningar
För svenska sajter finns en aspekt som sällan nämns, nämligen språket. Peec AI analyserade över 20 miljoner delfrågor och upptäckte att ChatGPT ofta byter till engelska:
- 43 % av delfrågorna för icke-engelska promptar kördes på engelska.
- I 78 % av fallen lade ChatGPT till minst en engelsk sökning, även när användarens plats matchade promptens språk.
- Andelen varierade från 66 % (spanska) till 94 % (turkiska). Inget språk låg under 60 %.
Svenska redovisas inte separat någonstans och Peec redogör inte heller för urvalsstorlek per språk.
MJ Cachóns data ger en viktig nyansering: Totalt sett var bara 8,9 % av delfrågorna på engelska, men skillnaden mellan projekten var stor: 1,0 % i det lokala projektet mot 27,3 % i det internationella. Frågor om lokala verksamheter verkar alltså stanna kvar på det lokala språket, medan frågor om produkter och tjänster med en global marknad gärna drar mot engelska.
För svenska företag som konkurrerar med internationella aktörer innebär det att en svensk kund som frågar på svenska ändå kan få ett svar som bygger på engelskspråkiga källor. Exempel från Peec: på polska frågor om auktionssajter nedprioriterades eller saknades Polens största, Allegro, till förmån för eBay och andra globala aktörer.
Vad betyder det här för SEO-arbetet?
Googles officiella hållning (som man visserligen aldrig ska ta som hela sanningen) är att det inte finns extra krav eller behövs särskilda optimeringar för att synas i AI Overviews eller AI Mode. Det är förvisso sant att fan-out kör vanliga sökningar mot ett vanligt index, så grundläggande SEO är fortfarande lika viktigt. Däremot förskjuts prioriteringarna.
1. Täck ämnet, inte bara sökordet
Surfers data talar för att bredd inom ett ämne lönar sig. En sida, eller ett kluster av sidor, som besvarar följdfrågorna har bättre chanser att dyka upp i fler träfflistor. Det kan gälla frågor om pris, jämförelser, för vem lösningen passar och så vidare. Tänk på vilka frågor en kunnig köpare skulle ställa och inte bara på vilka sökord som har volym.
2. Lägg fakta på egen domän, i HTML
Modellen letar allt oftare hos avsändaren: ”official”, ”price” och site: ökar. Cachón rekommenderar att varje faktauppgift om företaget har en indexerbar URL och att viktig information ligger i HTML, inte i PDF:er eller bilder. Seer såg att Gemini sökte efter ”Seer Interactive industry awards” och ”industries served” utan att hitta någon egen sida, så den hämtade svaren från tredje part. Priser, specifikationer, villkor, kundgrupper och certifieringar är alltid relevanta.
Ahrefs slutsats går i samma riktning. Sidor som sammanfattar andras innehåll tappar citeringar, medan innehåll som bara du kan publicera (produktfakta, egen data, egna tester) är värt desto mer.
3. Skriv passager som klarar sig själva
Modellen väljer inte hela sidor utan passager på sidorna. Ett avsnitt som besvarar en avgränsad delfråga tydligt och tidigt, utan att kräva sammanhanget runt omkring, är lättare att använda än ett mer spretigt och utspritt svar.
4. Var aktuell på riktigt
Årtal fanns med i nästan var fjärde delfråga hos Ahrefs. Uppdatera innehåll när det finns något att uppdatera, och visa datum tydligt. Den gamla klassikern att bara byta årtal i titeln utan att ändra innehållet löser inga problem längre.
5. Syns där modellen letar efter omdömen
”Reviews” och ”best” är bland de vanligaste tilläggen. Var du nämns i listicles, jämförelser och recensionssajter kan påverka modellens slutsatser. Dock har detta missbrukats i omfattande grad och helhetsbilden förändras snabbt. Hos Ahrefs föll Reddits (som varit en riktig spam-magnet) andel av ChatGPT-citeringarna med 88 % mellan mars och september 2026, och Wikipedias med 80 %. Myndigheter, branschorganisationer och testsajter med egna mätningar ökade istället. Ahrefs egen förklaring är att ChatGPT i allt högre grad går direkt till primärkällan, alltså den som sätter priset eller äger datan, och att OpenAI:s licensavtal med utgivare kan påverka vilka källor som lyfts fram.
6. Överväg engelskt innehåll strategiskt
Konkurrerar du med internationella aktörer kan synlighet i engelskspråkiga källor påverka även svenska kunders svar. Det behöver inte handla om att översätta allt, men kan hjälpa dig att finnas med där de engelska delfrågorna landar.
7. Behåll dina redirects
Modellen kan söka på gamla domäner och URL:er. Låt 301-redirects ligga kvar och släpp inte domänerna.
Vad du inte ska göra
Att bygga en sida per fan-out-fråga kan verka logiskt men slår fel. Delfrågorna är för instabila och har för låg volym för att det ska fungera. Googles spampolicy slår också ner på vad man kallar scaled content abuse – massproduktion av sidor (oftast med AI) – något som också märkts i de senaste Googleuppdateringarna.
Så tar du fram fan-out-frågor själv
Du behöver inte nödvändigtvis dyra verktyg för att förstå hur AI-sök hanterar frågorna i din bransch:
- Gemini API med Google Search-grounding returnerar vilka sökfrågor modellen faktiskt körde. Det är det närmaste rådata man kommer för Googles ekosystem.
- ChatGPT visar sina sökningar i konversationsdatan, som går att se i webbläsarens utvecklarverktyg (nätverksfliken).
- Qforia från iPullRank simulerar fan-out med Gemini. Det är en simulering, inte riktig data, men bra för idégenerering.
- Kommersiella verktyg som Ahrefs Brand Radar och Peec AI är som sagt dyra men spårar fan-out och citeringar.
Oavsett metod gäller samma arbetssätt:
- Välj 20–50 promptar som speglar hur dina kunder faktiskt frågar, gärna på både svenska och engelska.
- Kör varje prompt många gånger. Seer använde 13 körningar, och en enstaka körning visar bara en bråkdel av bilden.
- Gruppera delfrågorna i teman, till exempel med hjälp av ordpar.
- Prioritera teman som återkommer i en klar majoritet av körningarna.
- Kontrollera för varje tema om du har en sida som besvarar det och hur du rankar för temats mest naturliga sökning.
Förbehåll
Den här texten bygger på den bästa data som fanns när detta skrevs, men den har begränsningar:
- Nästan all data kommer från företag som säljer verktyg för AI-synlighet. Ahrefs, Peec AI, Surfer och Nectiv har alla kommersiella intressen i att ämnet uppfattas som viktigt.
- Datan är till största delen amerikansk. Svenska promptar har inte studerats separat.
- Modellerna ändras hela tiden. Nectiv såg antalet delfrågor tredubblas på ett år, medan Ahrefs såg tydliga förskjutningar på en enda månad.
- Hämtning betyder inte citering. Flera studier mäter vad modellen söker på, inte vad som till slut framgick i svaret.
Sammanfattning
Query fan-out förklarar varför AI-svar så ofta citerar sidor som inte rankar för den fråga användaren ställde. Modellen söker på något annat, kanske mer specifikt och med fler tillägg, ofta direkt hos avsändaren och ibland på engelska.
För SEO-arbetet betyder det att ämnestäckning väger tyngre än enskilda sökord. Fakta om din verksamhet behöver finnas på din egen sajt i enkelt läsbar form. Också viktigt är att sökordsverktygen i bästa fall bara visar ett utsnitt av vad modellerna söker på.
Vill du veta hur din sajts synlighet står sig i AI-eran? Som SEO-konsult hjälper jag företag att kartlägga vilka frågor AI-sök ställer och var luckorna finns. Läs också om hur Googles AI-översikter påverkar klickfrekvensen.